SSM框架-Redis

1.Redis概述

第1关:Redis简介

REmote DIctionary Server(Redis) 是一个由Salvatore Sanfilippo写的key-value存储系统。

Redis是一个开源的使用ANSI C语言编写、遵守BSD协议、支持网络、可基于内存亦可持久化的日志型、Key-Value数据库,并提供多种语言的API。

它通常被称为数据结构服务器,因为值(value)可以是 字符串(String), 哈希(Hash), 列表(list), 集合(sets) 和 有序集合(sorted sets)等类型。

相关知识

Redis是什么?

Redis是一个完全开源免费、高性能的key-value数据库。所谓key-value数据库是一种以键值对存储数据的数据库。类比于Java中的Map,可以将整个数据库理解为一个大型的Map,每个键都会对应一个唯一的值。 Redis与其他key-value产品相比有以下三个特点:

  • Redis支持数据的持久化,可以将内存中的数据保存在磁盘中,重启的时候可以再次加载进行使用;
  • Redis不仅仅支持简单的key-value类型的数据,同时还提供list,set,zset,hash等数据结构的存储;
  • Redis支持数据的备份,即master-slave(主从)模式的数据备份。

Redis数据库的下载安装请参考Redis中文官方网站。

Redis 的优势

  • 性能极高,官方数据表示Redis能读的速度是110000次每秒,写的速度是81000次/秒 ;
  • 丰富的数据类型, Redis支持二进制案例的Strings, Lists, Hashes, Sets 及 Ordered Sets 数据类型操作;
  • 原子性,Redis的所有操作都是原子性的,意思就是要么成功执行,要么失败完全不执行。单个操作是原子性的。多个操作也支持事务,即原子性,通过MULTI和EXEC指令包起来;
  • 丰富的特性,Redis还支持 publish/subscribe(发布订阅), 通知, key过期等等特性。

Redis 的用途

Redis的所有数据在使用时都存放在内存中,由于Redis的性能极高,且数据类型丰富等优势,Redis通常被用来缓存应用经常被访问的热点数据。当然,Redis还有其它用途,如分布式锁、计数器等等,不详细介绍。

Java 中连接Redis

在Java中使用Redis前,我们需要确保已经安装了Redis服务及对应的Java Redis驱动,并且在你的机器上配置好了Java环境。这些环境配置在实训环境中已经为你配置好了,在此不需要关注。如果在自己电脑上使用,需要从官网下载Redis安装,并把Java Redis驱动文件Jedis.jar添加到ClassPath中。

下面代码是完成环境配置后,在Java代码中连接Redis的示例。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
package step3;
import redis.clients.jedis.Jedis;
public class ConnRedisDemo {
public static void main(String[] args) {
//redis数据所在的主机,如果是redis安装在本机,则是localhost或127.0.0.1
String redisHost = "192.168.1.134";
int redisPort=6379;//Redis监听的端口,默认为6379
//创建1个Jedis对象。这是用来操作Redis数据库
Jedis jedis = new Jedis(redisHost,redisPort);
System.out.println("连接成功");
String resp = jedis.ping();//调用jedis的方法,查看服务是否运行
System.out.println("Redis服务正在运行" + resp);//
jedis.close();//关闭redis连接
}
}

上面代码中,我们连接的是位于主机192.168.1.134上的Redis数据库,Redis数据库监听的端口号为6379(默认端口)。如果Redis服务正常运行,上面代码输出如下。

  1. 连接成功
  2. Redis服务正在运行PONG

Redis 字符串实例

Redis支持的数据类型非常丰富,下面是一个操作字符串类型key-value的示例。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
package step3;
import redis.clients.jedis.Jedis;
/**
* @author zpengx@outlook.com
* @description
*/
public class RedisStrDemo {
public static void main(String[] args) {
String redisHost = "192.168.1.128";//Redis数据所在的主机
int redisPort = 6379;//Redis监听的端口,默认为6379
Jedis jedis = new Jedis(redisHost, redisPort);
System.out.println("连接成功");
//保存一个字符串类型的key-value对到Redis中
jedis.set("educoder", "www.educoder.net");
//根据key从Redis中取出数据输出
String val = jedis.get("educoder");
String val2 = jedis.get("educoder2");
System.out.println("Redis存储的字符串为: " + val);
System.out.println("Redis存储的字符串为: " + val2);
jedis.close();
}
}

首先我们通过指定IP和端口连接上对应的Redis数据库,然后把一个key为educoder,value为www.educoder.net的键值对存入Redis中,然后通过key获取对应的value的值。而对于jedis.get("educoder2"),因为Redis中没有key为educoder2的键值对,所以返回null。上面代码的输出结果如下:

  1. 连接成功
  2. Redis存储的字符串为: www.educoder.net
  3. Redis存储的字符串为: null

任务代码

编程要求

现有键值对:key1:welcome,key2:to,key3:www,key4:educoder,key5:net。根据提示,在右侧编辑器 Begin-End 区间补充redisExec(Jedis jedis)方法的代码,实现如下功能:

  • 把上面这些键值对存入Redis中;
  • 根据key从Redis中取出value的值,拼成一个字符串并返回,相邻value之间有空格。

返回的字符串为welcome to www educoder net ,测试代码会输出返回的字符串。

RedisDemo.java

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
package com.test;

import redis.clients.jedis.Jedis;

public class RedisDemo {
private static String[] keys = new String[]{"key1", "key2", "key3", "key4", "key5"};
private static String[] values = new String[]{"welcome", "to", "www", "educoder", "net"};

//jedis对象已经连接Redis数据库,请直接使用jedis对象操作
public String redisExec(Jedis jedis) {

//retStr保存拼接的字符串
//期望的返回结果是welcome to www educoder net
StringBuilder retStr = new StringBuilder();

/********** Begin *********/
String val="";
for(int i=0;i<keys.length;i++){
jedis.set(keys[i],values[i]);
val=val+jedis.get(keys[i])+' ';
}
jedis.close();
retStr.append(val);
/********** End *********/

return retStr.toString();
}
}

2.Redis常用数据结构

第1关:Redis中的数据结构

相关知识

Redis简介

Redis 是一个速度非常快的非关系型数据库(non-relational database),它可以存储键(key)和五种不同类型的值(value)之间的映射(mapping),可基于内存存储亦可持久化到硬盘的日志型,Key-Value 数据库。

Redis与其他数据库的对比

如果你使用过关系型数据库,例如:Mysql,那么你肯定写过关联两张表数据的查询语句。而 Redis 属于 NoSQL,它不使用表,也不会预定义数据模式或强制用户对 Redis 的各种数据进行关联。

NoSQL(Not Only SQL)

意指“不仅仅是SQL”,其泛指非关系型数据库,主要分为四类:键值(Key-Value)存储数据库,列存储数据库,文档型数据库,图形(Graph)数据库。

Redis 也经常与高性能键值缓存服务器 memcached 做比较:两者均可用于存储键值映射,性能相差也甚少,但 Redis 能存储除普通字符串值之外的四种数据结构,而 memcached 只能存储普通的字符串值。这些不同使得 Redis 能够解决更为广泛的问题,而且既能作为主数据库使用,也可以作为辅助数据库使用。

我们通过一张表来对比常用的数据库与缓存服务器:

名称 类型 数据存储选项 查询类型 附加功能
Redis 基于内存的非关系型数据库 字符串、列表、集合、哈希、有序集合 针对数据类型有专属命令,另有批量操作和不完全的事务支持 发布与订阅、复制、持久化、脚本扩展
memcached 基于内存的键值缓存 键值映射 创建、读取、更新、删除等 多线程支持
MySQL 关系型数据库 数据表、视图等 查询、插入、更新、删除、内置函数、自定义存储过程等 支持 ACID 性质、复制等
MongoDB 基于硬盘的非关系型文档存储数据库 无 schema 的 BSON 文档 创建、读取、更新、删除、条件查询等 复制、分片、空间索引等

Redis的特性

由于 Redis 是内存型数据库,在使用之前就要考虑当服务器被关闭时,服务器存储的数据是否能保留。Redis 拥有两种不同形式的持久化方法,都可以用紧凑的格式将数据写入硬盘:

  • RDB持久化

    • 在指定的时间间隔内生成数据集的时间点快照
  • AOF 持久化

    • 记录服务器执行的所有写操作命令
    • 新命令会被追加到文件的末尾
    • 在服务器启动时,通过重新执行这些命令还原数据集

除此之外,为了扩展 Redis 的读性能,并为 Redis 提供故障转移支持,Redis 实现了主从复制特性:

  • 执行复制的从服务器连接主服务器
    • 接收主服务器发送的初始副本
    • 接收主服务器执行的所有写命令
  • 在从服务器上执行所有写命令,实时更新数据库
  • 读命令可以向任意一个从服务器发送

快速安装 Redis

为了避免安装到旧版 Redis 的问题,我们直接使用源码编译安装 Redis,首先你需要获取并安装 make 等一系列构建工具:

1
2
$ sudo apt-get update
$ sudo apt-get install make gcc python-dev

构建工具安装完毕后,你需要执行以下操作:

  • 从 https://redis.io/download 下载最新的稳定版本 Redis 源码
  • 解压源码,编译、安装并启动 Redis

其中,安装 Redis 的过程如下:

1
2
3
4
5
6
7
8
9
~:$ wget -q http://download.redis.io/releases/redis-5.0.0.tar.gz
~:$ tar -xzf redis-5.0.0.tar.gz
~:$ cd redis-5.0.0
# 注意观察编译消息,最后不应该产生任何错误(`Error`)
~/redis-5.0.0:$ make
# 注意观察安装消息,最后不应该产生任何错误(`Error`)
~/redis-5.0.0:$ sudo make install
# 启动 Redis 服务器,注意通过日志确认 Redis 顺利启动
~/redis-5.0.0:$ redis-server redis.conf

除了上述的启动 Redis 服务器方式,你还可以通过 Redis 默认的配置在后台启动它(常用启动方式):
$ redis-server &

Redis数据结构简介

Redis 的五种数据结构分别是:

  • 字符串(STRING)
  • 列表(LIST)
  • 集合(SET)
  • 哈希(HASH)
  • 有序集合(ZSET)

ZSET 可以说是 Redis 特有的数据结构,我们会在之后的实训中详细介绍它,在本实训中,我们只简要介绍他们的功能和小部分命令。他们的存储的值如下:

结构类型 存储的值
STRING 字符串、整数或浮点数
LIST 一个链表,上面的每个节点都是一个字符串
SET 包含若干个字符串的无序集合,且集合中的元素都是唯一的
HASH 包含键值对的无序散列表
ZSET 成员中的字符串与分值的有序映射,其排序由分值决定

在安装完 Redis 并启动了 redis-server 后,我们可以使用 redis-cli 控制台与 Redis 进行交互,其启动方式是在终端中输入:
$ redis-cli

其会默认连接本机 6379 端口启动的 Redis 服务器,接下俩你可以使用它来体验 Redis 各种数据结构和其命令的使用。

Redis中的字符串

STRING 拥有一些和其他键值存储相似的命令,比如 GET(获取值),SET(设置值),DEL(删除值)等,例如:

1
2
3
4
5
6
7
8
9
$ redis-cli
redis-cli 127.0.0.1:6379> set hello redis
OK
redis-cli 127.0.0.1:6379> get hello
"redis"
redis-cli 127.0.0.1:6379> del hello
(integer) 1
redis-cli 127.0.0.1:6379> get hello
(nil)

其中:

  • SET 命令的第一个参数是键(Key),第二个参数是值(Value)
  • 尝试获取不存在的键时会得到一个 nil
Redis中的列表

就像前面所说的,Redis 中的列表是一个“链表”,这和大多数编程语言相似。所以他们的操作也十分相似:

  • LPUSH 命令可用于将元素推入列表的左侧
  • RPUSH 命令可将元素推入列表的右侧
  • LPOP 和 RPOP 就分别从列表的左侧和右侧弹出元素
  • LINDEX 可以获取指定位置上的元素
  • LRANGE 可以获取指定范围的全部元素

我们通过 redis-cli 来亲自体验:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
redis 127.0.0.1:6379> rpush testlist item
(integer) 1
redis 127.0.0.1:6379> rpush testlist item2
(integer) 2
redis 127.0.0.1:6379> rpush testlist item
(integer) 3
redis 127.0.0.1:6379> lrange testlist 0 -1
1) "item"
2) "item2"
3) "item"
redis 127.0.0.1:6379> lindex testlist 1
"item2"
redis 127.0.0.1:6379> lpop testlist
"item"
redis 127.0.0.1:6379> lrange testlist 0 -1
1) "item2"
2) "item"

我们可以看出,在列表中,元素可以重复出现。在后续的实训中,我们还会介绍更多列表命令,现在我们先来了解以下 Redis 中的集合。

Redis中的集合

集合和列表的区别就在于:列表可以存储多个相同的字符串,而集合通过散列表来保证存储的字符串都是各不相同的(这些散列表只有键,而没有对应的值)。

由于集合是无序的,所以我们只能通过统一的 SADD 命令将元素添加到集合中,SREM 命令将元素从集合中移除。你还可以通过:

  • SMEMBERS 命令获取到集合中的所有元素
  • SISMEMBER 命令来判断一个元素是否已存在在集合中
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
redis 127.0.0.1:6379> sadd testset item
(integer) 1
redis 127.0.0.1:6379> sadd testset item2
(integer) 1
redis 127.0.0.1:6379> sadd testset item
(integer) 0
redis 127.0.0.1:6379> smembers testset
1) "item"
2) "item2"
redis 127.0.0.1:6379> sismember testset item3
(integer) 0
redis 127.0.0.1:6379> sismember testset item
(integer) 1
redis 127.0.0.1:6379> srem testset item2
(integer) 1
redis 127.0.0.1:6379> srem testset item2
(integer) 0
redis 127.0.0.1:6379> smembers testset
1) "item"

上面示例的集合中包含的元素少,所以执行 SMEMBERS 命令没有问题,一旦集合中包含的元素非常多时,SMEMBERS 命令的执行速度会很慢,所以要谨慎的使用这个命令。

Redis中的哈希

哈希可以存储多个键值对之间的映射。和字符串一样,哈希存储的值既可以是字符串又可以是数字值,并且可以对数字值进行自增/自减操作。

哈希就像是一个缩小版的 Redis,有一系列命令对哈希进行插入、获取、删除:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
redis 127.0.0.1:6379> hset testhash key1 value1
(integer) 1
redis 127.0.0.1:6379> hset testhash key2 value2
(integer) 1
redis 127.0.0.1:6379> hset testhash key1 newvalue
(integer) 0
redis 127.0.0.1:6379> hgetall testhash
1) "key1"
2) "newvalue"
3) "key2"
4) "value2"
redis 127.0.0.1:6379> hdel testhash key2
(integer) 1
redis 127.0.0.1:6379> hget testhash key1
"newvalue"
redis 127.0.0.1:6379> hgetall testhash
1) "key1"
2) "newvalue"

其中:

  • hset用于插入元素
    • 第一个参数为该哈希的键名,如果该哈希不存在,则创建一个
    • 第二个参数为哈希中的域名
      • 如果不存在,则创建该域,并与第三个参数的值进行映射
      • 如果存在,则使用第三个参数更新该域的值
    • 第三个参数为哈希中的值
  • hgetall 会获取到该哈希的所有域-值对
  • hget 用于获取哈希中的某一个域
  • hdel 用户删除哈希中的某一个域
Redis中的有序集合

有序集合和哈希一样,也是存储键值对。

只是有序集合的键被称为成员(member),每个成员都是唯一的,有序集合的值则被称为分值(score),这个分值必须为浮点数。所以有序集合既可以通过成员访问元素,也可以通过分值来排序元素。

我们可以通过:

  • ZADD 命令将带有指定分值的成员添加到有序集合中
  • ZRANGE 命令根据分值有序排列后的集合获取到指定范围的元素
  • ZRANGEBYSCORE 命令获取指定分值范围内的元素
  • ZREM 命令从有序集合中删除指定成员

我们也可以在 redis-cli 中验证上述命令的功能:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
redis 127.0.0.1:6379> zadd testzset 100 member1
(integer) 1
redis 127.0.0.1:6379> zadd testzset 200 member0
(integer) 1
redis 127.0.0.1:6379> zrange testzset 0 -1 withscores
1) "member1"
2) "100"
3) "member0"
4) "200"
redis 127.0.0.1:6379> zrangebyscore testzset 0 150 withscores
1) "member1"
2) "100"
redis 127.0.0.1:6379> zrem testzset member1
(integer) 1
redis 127.0.0.1:6379> zrange testzset 0 -1 withscores
1) "member0"
2) "200"

任务代码

编程要求

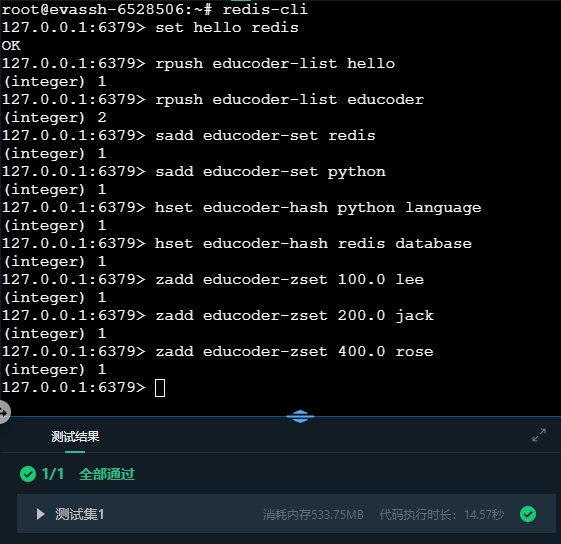
根据提示,打开命令行,启动 Redis 客户端并创建一些值:

  • 使用默认配置后台启动 Redis 服务器
  • 启动 Redis 客户端 redis-cli
  • 设置字符串
    • 键为 hello
    • 值为 redis
  • 设置列表,键为 educoder-list
    • 从列表左侧推入元素 hello
    • 从列表右侧推入元素 educoder
      从列表右侧推入元素 bye
    • 从列表右侧弹出一个元素
  • 设置集合,键为 educoder-set
    • 添加元素 c
    • 添加元素 python
    • 添加元素 redis
    • 删除元素 c
  • 设置哈希,键为 educoder-hash
    • 添加键:python,值为:language
    • 添加键:ruby,值为:language
    • 添加键: redis,值为:database
    • 删除键 ruby
  • 设置有序列表,键为 educoder-zset
    • 添加成员 jack,分值为 200
    • 添加成员 rose,分值为 400
    • 添加成员 lee,分值为 100

命令行

1
2
3
4
5
6
7
8
9
10
11
redis-cli
set hello redis
rpush educoder-list hello
rpush educoder-list educoder
sadd educoder-set python
sadd educoder-set redis
hset educoder-hash python language
hset educoder-hash redis database
zadd educoder-zset 100.0 lee
zadd educoder-zset 200.0 jack
zadd educoder-zset 400.0 rose

命令行粘贴:Ctrl+Shift+v 或者鼠标右键粘贴

示例图

第2关:Java操作Redis的数据

连接 Redis

1
2
3
String redisHost = "127.0.0.1";
int redisPort=6379;
Jedis jedis = new Jedis(redisHost,redisPort);

相关知识

String数据类型

字符串是 Redis 最基本的数据结构,它将以一个键和一个值存储于 Redis 内部,它犹如 Java 的 Map 结构,让 Redis 通过键去找到值。常用命令:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
//设置字符串
jedis.set("key", "value");
//使用append 向字符串后面添加
jedis.append("key", " value2");
// set覆盖字符串(如果有key的话会直接将value的值替换为当前值)
jedis.set("key", "value3");
//设置数据过期时间(中间数字是秒数,为过期的时间)
jedis.setex("key2", 10, "value");
//一次添加多个key-value对
jedis.mset("key", "1", "key2", "2");
//获取多个key的value
jedis.mget("key", "key2");
//批量删除
jedis.del("key", "key2");
//清除jedis所有key值
jedis.flushDB()

linked-list链表

linked-list与客户端命令用的大概是一致的,Redis 中的列表是一个“链表”,链表结构是 Redis 中一个常用的结构,它可以存储多个字符串,而且它是有序的。Redis 链表是双向的,因此即可以从左到右,也可以从右到左遍历它存储的节点。

而链表结构的优势在于插入和删除的便利,因为链表的数据节点是分配在不同的内存 区域的,并不连续,只是根据上一个节点保存下一个节点的顺序来索引而己,无需移动元素。常用命令:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
//向右侧添加数据
jedis.rpush("key","value","value2","value3");
//向左侧添加数据
jedis.lpush("key","value","value2","value3");
//获取List集合的长度
jedis.llen("key");
//打印队列,从索引0开始,到倒数第1个(全部元素)
//如果stop比list的实际尾部大的时候,Redis会当它是最后一个元素的下标。
jedis.lrange("key", 0, -1)
//查找索引为1的值
jedis.lindex("key", 1)
//将索引为1的值替换为value4
jedis.lset("key", 1, "value4");
//从队列左边弹出一个元素(删除)
jedis.lpop("key")
//从队列右边弹出一个元素(删除)
jedis.rpop("key")
/*中间数字为count
count > 0: 从左边开始移除值为 value 的元素,count为移除的个数。
count < 0: 从右侧开始移除值为 value 的元素,count为移除的个数。
count = 0: 移除所有值为 value 的元素。*/
jedis.lrem("key", -2, "value");
//删除区间以外的元素
jedis.ltrim("key", 0, 2)

集合

Redis的集合是一个哈希表结构,它是无序的。集合可以对于两个或者两个以上的集合进行交集、差集与并集等等。对于集合而言,它的每一个元素都是不能重复的,当插入相同记录的时候都会失败。集合的每一个元素都是 String 数据结构类型。常用命令:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
//新增集合,添加数据
jedis.sadd("key", "v1", "v2", "v3");
jedis.sadd("key2", "v2", "v3", "v4");
//获取集合中所有元素
jedis.smembers("key")
//获取集合中的元素数量
jedis.scard("key");
//获得两个集合的交集,并存储在一个关键的结果集
jedis.sinterstore("key3", "key", "key2");
//key1集合中,key2集合没有的元素,并存储在一个关键的结果集
jedis.sdiffstore("key3", "key", "key2");
//判断集合是否存在这元素,返回Boolean类型
jedis.sismember("key", "v1");
//从集合里面随机获取一个元素
jedis.srandmember("key");
//将集合元素转移到另一个集合中
jedis.smove("key", "key2", "v2");
//删除并获取一个集合里面的元素(从左侧开始)
jedis.spop("key")
//从集合里删除一个或多个元素(指定)
jedis.srem( "key2", "v2", "v3");

Hash类型集合

Redis 中哈希结构就如同 Java 的 map 一样, 一个对象里面有许多键值对,它是特别适 合存储对象的,在 Redis 中,hash 是一个 String 类型的 field 和 value 的映射表,因此我们存储的数据实际在 Redis 内存中都是一个个字符串而己。

在 Redis 中的哈希结构和字符串有着比较明显的不同。首先, 命令都是以 h 开头,代表操作的是 hash 结构。其次,大多数命令多了一个层级 field,这是 hash 结构的一个内部键,也就是说 Redis 需要通过 key 索引到对应的 hash 结构,再通过 field 来确定使用 hash 结构的哪个键值对。常用命令:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
Map<String, String> hash = new HashMap<>();
hash.put("k1", "v1");
hash.put("k2", "v2");
hash.put("k3", "v3");
//添加数据
jedis.hmset("key", hash);
//追加数据
jedis.hset("key", "k4", "100");
//获取hash的所有元素(key值)
jedis.hkeys("key");
//获取hash中所有的key对应的value值
jedis.hvals("key");
//获取hash里所有元素的数量
jedis.hlen("key");
//获取hash中全部的域和值,以 Map<> 的形式返回
jedis.hgetAll("key");
//判断给定key值是否存在于 Hash 集中
jedis.hexists("key", "k2");
//获取hash里面指定字段对应的值
jedis.hget(key, "aaa")
//获取hash里面指定多个字段对应的值
jedis.hmget("key", "k2","k3");
//删除指定的字段
jedis.hdel("key", "k1");
//如果字段值为Int类型,可以为值加上增量
jedis.hincrBy("key", "k4", 100);

有序集合

有序集合和集合命令是差不多的,只是在这些命令基础上,有序集合会多一个浮点数的分数,会增加对于排序的操作,这是我们需要注意的地方。常用命令:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
//添加数据
jedis.zadd("key", 1000, "k1");
jedis.zadd("key", 1500, "k2");
jedis.zadd("key", 2000, "k3");
jedis.zadd("key", 2500, "k4");
//也可以直接添加Map集合
Map<String, Double> keyvalue = new HashMap<>();
keyvalue.put("k1",1000.0);
keyvalue.put("k2",1500.0);
keyvalue.put("k3",2000.0);
keyvalue.put("k4",2500.0);
jedis.zadd("key",keyvalue);
//获取有序集合的数量
jedis.zcard("key");
//查询集合所有元素名(左侧)
jedis.zrange("key", 0, -1);
//查询集合所有元素名(右侧)
jedis.zrevrange("key", 0, -1);
//查询指定范围内元素名
jedis.zrangeByScore("key",1000.0,2000.0);
//查询元素下标
jedis.zscore("key", "k3");
//删除元素
jedis.zrem("key", "k2");
//查询指定范围内元素的数量
jedis.zcount("key", 1000.0, 2000.0)
//查询集合所有内容(带有序列)
jedis.zrangeWithScores("key",0, -1);
//查询指定范围的内容(带有序列)
jedis.zrangeByScoreWithScores("key",1000.0,2000.0);

任务代码

编程要求

根据提示,在右侧编辑器补充代码,根据以下要求去使用Java 操作 Redis: 1、哈希表名为name_password。

  • 查询出用户有多少。
  • 将lisi的密码修改为ls456789。

2、有序列表名为student_scores。

  • 查询出分数为600分到800分之间的同学学生姓名和分数
  • 小红的分数少加了20分,请给她加上去

Step2RedisTest.java

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
package com.test;
import redis.clients.jedis.Jedis;
import redis.clients.jedis.Tuple;
import java.util.Set;
public class Step2RedisTest {
public static void main(String[] args) {
String redisHost = "127.0.0.1";
int redisPort = 6379;
Jedis jedis = new Jedis(redisHost, redisPort);
AddRedis addRedis=new AddRedis();
addRedis.add();
/**********Begin**********/
//查询出用户有多少
System.out.println("用户数量为:"+jedis.hlen("name_password"));
System.out.println("------------------------");
//将lisi的密码修改为ls456789
jedis.hset("name_password","lisi","ls456789");
System.out.println("修改后的密码为:"+jedis.hget("name_password","lisi"));
System.out.println("------------------------");
//查询出分数为600分到800分之间的同学学生姓名和分数
Set<Tuple> student_scores = jedis.zrangeByScoreWithScores("student_scores", 600, 800);
System.out.println("600分到800分之间的同学为:");
for (Tuple score:student_scores){
System.out.println(score.getElement()+"-"+score.getScore());
}
System.out.println("------------------------");
//小红的分数错误了,少加了20分,请给她加上去
jedis.zincrby("student_scores",20,"xiaohong");
Double zscore = jedis.zscore("student_scores", "xiaohong");
System.out.println("小红的修改后的分数为:"+zscore);
/**********End**********/
//删除所有key值
jedis.flushDB();
jedis.close();
}
}

3.Redis一些常用的技术

第1关:Redis 事务与锁机制

1.Redis 的基础事务。 2.Redis 事务回滚。 3.使用 watch 命令监控事务。

相关知识

在 Redis 中,也存在多个客户端同时向 Redis 系统发送命令的并发可能性,因此同一个 数据,可能在不同的时刻被不同的线程所操纵,这样就出现了并发下的数据一致的问题。 为了保证异性数据的安全性,Redis 为提供了事务方案。下面就是Redis事务命令:

命令 说明 备注
multi 开始事务命令,之后的命令进入队列,而不会马上执行 在事务生存期间,所有的 Redis 关于数据结构的命令都会入队
watch key1 [key2 ……] 监听某些键,当被监听的键在事务执行前被修改,则事务会被回滚 使用乐观锁
unwatch key1 [key2 ……] 取消监听某些键
exec 执行事务,如果被监听的键没有被修改,则采用执行命令,否则就回滚命令 在执行事务队列存储的命令前,Redis 会检测被监听的键值对有没有发生变化,如果没有则执行命令,否则就回滚事务
discard 回滚事务 回滚进入队列的事务命令,之后就不能再用 exec命令提交了

Redis的基础事务

multi 到 exec 命令之间的 Redis 命令将采取进入队列的形式,直至 exec 命令的出现,才会一次性发送队列里的命令去执行,而在执行这些命令的时候其他客户端就不能再插入任何命令了。 事务过程演示 由上演示图可以看出,multi先开启了事务,然后进入set和get命令,发现传回来一个“QUEUED”的结果,说明Redis将命令放入队列中,但是并不会直接执行,等到执行exec命令时,才会把队列中的命令发给Redis服务器依次执行。最后输出显示出来“OK”和“value”。 也可以利用Java来开启 Redis 事务。
1
2
3
4
Transaction transaction=jedis.multi();
transaction.set("key","value");
transaction.get("key");
System.out.println(transaction.exec());

结果返回:

1
[OK, value]

Redis 事务回滚

在Redis中,不仅仅需要注意事务处理,其回滚能力也与数据库不太一样。 如果回滚事务,则可以使用 discard 命令,它就会进入在事务队列中的命令,这样事务 中的方法就不会被执行了。 事务回滚演示图 由上演示图可以看出,当我们使用了 discard 命令后,再使用 exec 命令时就会报错,因为 discard 命令已经取消了事务中的命令,而到了 exec 命令时,队列里面己经没有命令可以执行了,所以就出现了报错的情况。 Redis里面的事务也可以不使用 discard 自动回滚。分为倆种情况: 一种是数据类型错误。 事务回滚演示2 另一种是命令格式错误。 事务回滚演示3 通过上面两个例子,可以看出在执行事务命令的时候,在命令入队的时候, Redis 就会 检测事务的命令是否正确,如果不正确则会产生错误。无论之前和之后的命令都会被事务 所回滚,就变为什么都没有执行。当命令格式正确,而因为操作数据结构引起的错误,则 该命令执行出现错误,而其之前和之后的命令都会被正常执行。这点和数据库很不一样, 这是需要读者注意的地方。对于一些重要的操作,我们必须通过程序去检测数据的正确性, 以保证 Redis 事务的正确执行,避免出现数据不一致的情况。 Redis 之所以保持这样简易的 事务,完全是为了保证移动互联网的核心问题一一性能。

使用 watch 命令监控事务

在 Redis 中使用 watch 命令可以决定事务是执行还是回滚。 一般而言,可以在 multi 命 令之前使用 watch 命令监控某些键值对,然后使用 multi 命令开启事务,执行各类对数据结 构进行操作的命令,这个时候这些命令就会进入队列。当 Redis 使用 exec 命令执行事务的 时候,它首先会去比对被 watch 命令所监控的键值对,如果没有发生变化,那么它会执行 事务队列中的命令,提交事务;如果发生变化,那么它不会执行任何事务中的命令,而去 事务回滚。无论事务是否回滚, Redis 都会去取消执行事务前的 watch 命令。 例如:
watch 命令就是这样的一个功能。 然后,开启线程 业务逻辑,由 multi 命令提供这一功能。在执行更新前,比较当前线程副本保存的旧值和当 前线程共享的值是否一致,如果不一致,那么该数据己经被其他线程操作过,此次更新失 败。为了保持一致,线程就不去更新任何值,而将事务回滚:否则就认为它没有被其他线 程操作过,执行对应的业务逻辑, exec 命令就是执行“类似”这样的一个功能。

Java使用 watch 命令监控事务,如下:

1
2
3
4
5
6
7
8
9
10
Jedis jedis = new Jedis(redisHost,redisPort);
jedis.flushDB();
jedis.set("key1", "value1");
jedis.watch("key1");
jedis.set("key1", "va1");
Transaction transaction = jedis.multi();
transaction.set("key2", "value2");
transaction.set("key1", "v1");
transaction.exec();
System.out.println(jedis.get("key2"));

结果返回null值,说明改变监控的值导致事务里的命令全部不会执行。

任务代码

编程要求

根据提示,在右侧编辑器Begin-End补充代码,根据以下要求完成一个模拟一次银行卡支付扣款的流程:

1、当余额不足时,放弃所有被监控的键,返回false。

2、在余额扣除消费的金额,在支付金额里加上消费的金额。

TestRedis.java

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
package com.test;
import redis.clients.jedis.Jedis;
import redis.clients.jedis.Transaction;

import java.util.List;

public class TestRedis {
private static String host = "127.0.0.1";
private static int port = 6379;
private static Jedis jedis = new Jedis(host, port);
public static boolean payMent(int deduction) throws InterruptedException {
int balance=0; // 余额
//设置余额金额

jedis.set("balance", "100");
jedis.set("deduction", "10");
//监控扣款和余额
jedis.watch("balance", "deduction");
/***********Begin***********/
// 余额不足
balance=Integer.parseInt(jedis.get("balance"));
if(balance<deduction){
return false;
}
// 开启事务
Transaction transaction = jedis.multi();
//扣钱
transaction.set("balance", "90");
transaction.set("deduction", "10");
//事务执行
transaction.exec();
//返回
return true;
/***********End***********/
}
public static void main(String[] args) throws InterruptedException {

boolean resultValue = payMent(10);
if (resultValue==true){
System.out.println("支付成功");
int balance = Integer.parseInt(jedis.get("balance"));
int deduction = Integer.parseInt(jedis.get("deduction"));
System.out.printf("本次扣款"+deduction+"元,余额为"+balance+"元");
}else{
System.out.println("支付失败");
}

jedis.close();
}
}

第2关:流水线

1.Redis 的流水线技术。

相关知识

Redis 的流水线技术

我们了解完 Redis 的基础事务后,也要知道 Redis 中的流水线技术。在事务中 Redis 提供了队列,这是一个可以批量执行任务的队列,这样性能就比较高,但是使用multi… exec 事务命令是有系统开销的,因为它会检测对应的锁和序列化命令。有时候我们希望在没有任何附加条件的场景下去使用队列批量执行一系列的命令,从而提高系统性能,这就是 Redis 的流水线 (pipelined)技术。 现如今Redis 执行读写速度十分快,而系统的瓶颈往往是在网络通信中的延时,例如当命令 1 在时刻 T1 发送到 Redis 服务器后, 服务器就很快执行完了命令 1,而命令 2 在 T2 时刻却没有通过网络送达 Redis 服务器,这 样就变成了 Redis 服务器在等待命令 2 的到来,当命令 2 送达,被执行后,而命令 3 又没 有送达 Redis, Redis 又要继续等待,依此类推,这样 Redis 的等待时间就会很长,很多时候在空闲的状态,而问题出在网络的延迟中,造成了系统瓶颈。

为了解决这个问题,可以使用 Redis 的流水线, 但是 Redis 的流水线是一种通信协议,没有办法通过客户端演示给大家,不过我们可以通过 JavaAPI 或者使用 Spring 操作它,先使用 JavaAPI 去测试一下它的性能。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
JedisPool pool = getPool();
Jedis jedis = pool.getResource();
long start1 = System.currentTimeMillis();
for (int i = 0; i < 10000; i++) {
jedis.set("k"+i,"v"+i);
jedis.get("k"+i);
}
// 结束时间
long end1 = System.currentTimeMillis();
System.out.println("耗时: " + (end1 - start1) + "毫秒");
long start = System.currentTimeMillis();
// 开启流水线
Pipeline pipeline = jedis.pipelined();
// 测试十万条读/写操作
for (int i = 0; i < 100000; i++) {
pipeline.set("k"+i,"v"+i);
pipeline.get("k" + i);
}
List result = pipeline.syncAndReturnAll();
long end = System.currentTimeMillis();
System.out.println("耗时: " + (end - start) + "毫秒");
jedis.close();

上面没有用流水线的处理10000次请求时间大概为5000多毫秒,然而使用流水线的处理10000次请求时间大概500毫秒最右,最多快了十倍左右。所以我们平常使用 Redis 时不会经常去使用流水线,但是在企业公司或者较大数量的请求去使用 Redis 时,我们需要去考虑他的性能是不是最优,所以在这里使用流水线会大大减少我们处理的时间。

任务代码

编程要求

根据提示,在右侧编辑器Begin-End补充代码,按照以下要求开启一次流水线技术:

  • 开启流水线。
  • 测试十万条读写操作,设置 key 值为 key0 、 key1 、 key2 …key99998、key99999,对应 value 值为 value0 、value1、value2…value99998、value99999。
  • 结束流水线。

RedisPipeline.java

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
package com.test;
import redis.clients.jedis.*;
import java.util.List;
public class RedisPipeline {

public boolean pipeline() {
String redisHost = "127.0.0.1";
int redisPort = 6379;
Jedis jedis = new Jedis(redisHost, redisPort);
jedis.flushDB();
/**********Begin**********/
long start = System.currentTimeMillis();
// 开启流水线
Pipeline pipeline = jedis.pipelined();
System.out.println("开启流水线");

// 测试十万条读写操作
for (int i = 0; i < 100000; i++) {
pipeline.set("key"+i,"value"+i);
pipeline.get("key" + i);
}

long end = System.currentTimeMillis();
//关闭流水线
List result = pipeline.syncAndReturnAll();
System.out.println("消耗时间:"+(end-start)+"毫秒");
System.out.println("关闭流水线");
/**********End**********/
return true;

}
}

第3关:发布订阅

1.Redis 发布订阅技术。2. 利用 Java 来实现发布订阅的流程。

相关知识

Redis 发布订阅技术

其实发布订阅技术我们日常生活中常常见到,每次支付消费时,都会接收到一条交易信息,显示当前这笔消费的时间、金额等信息,这种便是一种发布订阅的模式。这里的发布是交易信息的发布,订阅则是各个渠道。这在 实际工作中十分常用, Redis 支持这样的一个模式。 发布订阅模式首先需要消息源,也就是要有消息发布出来,比如例子中的银行通知。首先是银行的系统,收到了交易的命令,成功记账后,它就会把消息发送出来,这个 时候,订阅者就可以收到这个消息进行处理了,观察者模式就是这个模式的典型应用了。

这里建立了一个消息渠道,短信系统和邮件系统都在监昕这个渠道,一旦记账系统把交易消息发送到消息渠道,则监昕这个渠道的各个系统就可以拿到这个消息,这样就能处理各自的任务了。它也有利于系统的拓展,比如现在新增一个彩信平台,只要让彩信平台去监听这个消息渠道便能得到对应的消息了。 从上面的分析可以知道以下两点:

  • 要有发送的消息渠道,让记账系统能够发送消息。
  • 要有订阅者(短信、邮件、微信等系统)订阅这个渠道的消息。

同样的, Redis 也是如此。首先来注册一个订阅的客户端,这个时候使用 SUBSCRIBE 命令,再用其他客户端使用PUBLISH将消息发布到订阅上,此时订阅的客户端显示被传输的消息。如下演示图: 发布订阅演示图 我们观察客户端 1 ,就可以发现已经收到了消息, 井有对应的信息打印出来。客户端的数字表示其出现的先后顺序,当发布消息的时候,对应的客户端已经获取到了这个信息。

利用 Java 来实现发布订阅的流程

我们首先定义了一个Subscriber类,这个类继承了JedisPubSub类,并重新实现了其中的回调方法。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
import redis.clients.jedis.JedisPubSub;
public class Subscriber extends JedisPubSub {
public Subscriber() {
}
@Override
public void onMessage(String channel, String message) {
System.out.println(String.format("接收redis发布消息, 频道为 %s, 信息为 %s", channel, message));
}
@Override
public void onSubscribe(String channel, int subscribedChannels) {
System.out.println(String.format("订阅redis频道成功, 频道为 %s, 订阅频道为 %d",
channel, subscribedChannels));
System.out.println("请输入传输的信息:");
}
@Override
public void onUnsubscribe(String channel, int subscribedChannels) {
System.out.println(String.format("取消订阅redis频道, 频道为 %s, 订阅频道为 %d",
channel, subscribedChannels));
}
}

在 Jedis 中,也提供了一个类 JedisPubSub,用来对订阅的 channel 进行监听。

  • onPMessage:监听到订阅模式接受到消息时的回调
  • onMessage:监听到订阅频道接受到消息时的回调
  • onSubscribe:订阅频道时的回调
  • onUnsubscribe:取消订阅频道时的回调
  • onPSubscribe:订阅频道模式时的回调
  • onPUnsubscribe:取消订阅模式时的回调

接下来订阅指定频道redis。

1
2
Subscriber subscriber=new Subscriber();
jedis.subscribe(subscriber,"redis");

然后在另外一台客户端发布订阅消息:

发布订阅消息

此时控制台输出:

1
2
3
接收redis发布消息, 频道为 redis, 信息为 hi redis

任务代码

编程要求

根据提示,在右侧编辑器Begin-End补充代码,按照以下要求:

  • 在SubThread类中订阅指定频道redis。

SubThread.java

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
package com.test;
import redis.clients.jedis.Jedis;
import redis.clients.jedis.JedisPool;
public class SubThread extends Thread {
private final JedisPool jedisPool;
private final Subscriber subscriber = new Subscriber();
private final String channel = "redis";
public SubThread(JedisPool jedisPool) {
super("SubThread");
this.jedisPool = jedisPool;
}
@Override
public void run() {
System.out.println(String.format("订阅redis, 订阅频道为 %s, 线程将被阻塞", channel));
Jedis jedis = null;
System.out.println(String.format("订阅redis频道成功, 频道为 %s, 订阅频道为 1",
channel));
System.out.println("请输入传输的信息:");
try {
/************* Begin ***************/
jedis = jedisPool.getResource();
jedis.subscribe(subscriber, channel);
/************* End ***************/
} catch (Exception e) {
System.out.println(String.format("订阅频道错误, %s", e));
} finally {
if (jedis != null) {
jedis.close();
}
}
}
}

第4关:超时命令

1.Redis 的超时命令。 2.使用 Spring 操作 Redis 超时命令。

相关知识

Redis的超时命令

我们平常使用的 Java 虚拟机,它提供垃圾回收的功能,此功能用来保证 Java 程序使用过的且不再使用的 Java 对象及时从内存中释放掉,使得内存空间还可用。当程序编写不当或者考虑欠缺的时候(比如读入大文件),内存就可能存储不下运行所需要的数据,那么 Java 虚拟机就会抛出内存溢出的异常而导致服务失败。同样, Redis 也是基于内存而运行的数据集合,也存在着对内存垃圾的回收和管理的问题。

Redis 基于内存,而内存对于一个系统是最宝贵的资源,而且它远远没有磁盘那么大,所以对于 Redis 的键值对的内存回收也是一个十分重要的问题,如果操作不当会产生 Redis 宕机的问题,使得系统性能低下。

当内存不足时 Redis 会触发自动垃圾回收的机制,而我们程序员可以通过System.gc()去建议 Java 虚拟机回收内存垃圾,他将可能触发一次 Java 虚拟机的回收机制,但是如果这样操作可能导致 Java 虚拟机在回收大量的内存空间的同时,引发性能低下的情况。对于 Redis 而言,del 命令是可以删除一些键值对,所以 Redis 比 Java 虚拟机更加灵活,允许删除一部分的键值对。与此同时,当内存运行空间满了之后,它还会按照回收机制去自动回收一些键值对,这和 Java 虚拟机又有相似之处,但是当垃圾进行回收的时候,又有可能执行回收而引发系统停顿,因此选择适当的回收机制和时间将有利于系统性能的提高,这是我们需要学习的地方。

我们学习 Redis 内存回收之前,首先要学习的是键值对的超市命令,因为大部分情况下,我们都想回收那些超时的键值对,并不是那些未超时的键值对。我们常用设置超时相关命令如下表:

命令 说明 备注
persist key 持久化key,取消超时时间 移除key的超时时间
ttl 查看key的超时时间 以秒计算,-1代表没有超时时间,如果不存在key或者key已经超时则为-2
expire key seconds 设置超时时间戳 以秒为单位
expireat key timestamp 设置超时时间点 用unix时间戳确定
pptl key milliseconds 查看key的超时时间戳 用毫秒计算
pexpire key 设置键值超时的时间 以毫秒为单位
pexpireat key stamptimes 设置超时时间点 以毫秒为单位的unix时间戳

下面展示这些命令在 Redis 客户端的使用:

 超时命令展示

我们探讨一个问题:如果 key 超时了,Redis 会回收 key 的存储空间吗?这也是面试时常常被问到的一个问题。

答案是不会回收,大家要注意的是: Redis 的 key 超时不会被其自动回收,它只会标识键值对超时了。这样做的好处在于如果一个很大的键值对超时,比如一个列表或者哈希结构,存在数以百万个元素,要对其回收需要很长的时间。如果采用超时回收,则可能产生停顿。坏处也很明显,这些超时的键值对会浪费比较多的空间。

Redis 提供两种方式回收这些超时键值对,它们是定时回收和惰性回收。

  • 定时回收是指在确定的某个时间触发一段代码,回收超时的键值对
  • 惰性回收则是当一个超时的键,被再次用 get 命令访问时,将触发 Redis 将其从内存中清空。

定时回收可以完全回收那些超时的键值对,但是缺点也很明显,如果这些键值对比较多,则 Redis 需要运行比较长的时间,从而导致停顿,所以系统设计者一般会选择在没有业务发生的时刻触发 Redis 的定时回收,以便清理超时的键值对。对于惰性回收而言,它的优势在于可以指定回收超时的键值对,他的缺点是要执行一个莫名奇妙的 get 操作,或者在某些时候,我们也难以判断哪些键值对已经超时。

无论是定时回收还是惰性回收,都要一句自身的特点去定制策略,如果一个键值对,存储的是数以千万的数据,使用 expire 命令使其到达一个时间超时,然后用 get 命令访问触发其回收,显然会付出停顿代价,这是我们现实中需要考虑的。

使用 Spring 操作Redis超时命令

除了使用客户端,我们也可以使用 Java 执行超时命令。

1
2
3
4
5
6
7
8
9
jedis.set("key1","value1");
System.out.println("key1值为:"+jedis.get("key1")) ;
System.out.println("过期时间:"+jedis.ttl("key1"));
jedis.expire("key1",120);
System.out.println( "过期时间:"+jedis.ttl("key1")) ;
jedis.persist("key1");
System.out.println("过期时间:"+jedis.ttl("key1"));
jedis.expireAt("key1",1594185996);
System.out.println("过期时间:"+jedis.ttl("key1"));

上面这段代码采用的就是 Java 操作Redis超时命令的一个过程,输出为:

1
2
3
4
5
key1值为:value1
过期时间:-1
过期时间:120
过期时间:-1
过期时间:6907

我们也可以结合 Spring 来操作 Redis 超时命令

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
ApplicationContext applicationContext=new ClassPathXmlApplicationContext("applicationContext.xml");
RedisTemplate redisTemplate=applicationContext.getBean(RedisTemplate.class);
redisTemplate.execute((RedisOperations ops) -> {
ops.boundValueOps("key1").set("value1");
String value = (String) ops.boundValueOps("key1").get();
System.out.println("value=" + value);
long expSecond = ops.getExpire("key1");
System.out.println("expSecond:" + expSecond);
// 设置120秒
Boolean flag = ops.expire("key1", 120L, TimeUnit.SECONDS);
System.out.println("设置超时时间:" + flag);
System.out.println("过期时间:" + ops.getExpire("key1") + "秒");
// 持久化 key,取消超时时间
flag = ops.persist("key1");
System.out.println("取消超时时间:" + flag);
System.out.println("过期时间:" + ops.getExpire("key1"));
//System.currentTimeMillis获取的是UNIX时间戳至今的格林尼治时间数
Date date = new Date();
date.setTime(System.currentTimeMillis() + 120000);
// 设置超时时间点
flag = ops.expireAt("key1", date);
System.out.println("设置超时时间:" + flag);
System.out.println("过期时间:" + ops.getExpire("key1"));
return null;
});

上面这段代码采用的就是 Spring 操作Redis超时命令的一个过程,输出为:

1
2
3
4
5
6
7
8
value=value1
expSecond:-1
设置超时时间:true
过期时间:120秒
取消超时时间:true
过期时间:-1
设置超时时间:true
过期时间:120

任务代码

编程要求

  • 根据提示,在右侧编辑器Begin-End补充代码,按照以下要求使用 Spring 操作 Redis 超时命令过程:
    • 创建键值对:key 值为“今天你吃了吗?”
    • 获取 key 值
    • 设置 key 的过期时间为 5 秒

OverTimeRedisTest.java

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
package com.redis;
import org.springframework.context.ApplicationContext;
import org.springframework.context.support.ClassPathXmlApplicationContext;
import org.springframework.data.redis.core.RedisOperations;
import org.springframework.data.redis.core.RedisTemplate;
import redis.clients.jedis.Jedis;
import redis.clients.jedis.JedisPool;
import redis.clients.jedis.JedisPoolConfig;
import java.util.concurrent.TimeUnit;
public class OverTimeRedisTest {
@SuppressWarnings({ "unchecked", "rawtypes", "resource" })
public static void main(String[] args) {
ApplicationContext applicationContext=new ClassPathXmlApplicationContext("applicationContext.xml");
RedisTemplate redisTemplate=applicationContext.getBean(RedisTemplate.class);
redisTemplate.execute((RedisOperations ops) -> {
/************Begin************/
ops.boundValueOps("key").set("今天你吃了吗?");
String value = (String) ops.boundValueOps("key").get();
System.out.println(value);
ops.expire("key", 5L, TimeUnit.SECONDS);
/************End************/
//睡眠6秒,使得key值过期
try {
Thread.sleep(6000);
}catch (InterruptedException e){
e.printStackTrace();
}
//获取key值
System.out.println((String)ops.boundValueOps("key").get());
//结束所有线程,退出系统
System.exit(0);
return null;
});
}
}

第5关:使用Lua语言

在 Redis 的 2.6 以上版本中,除了可以使用命令外,还可以使用 Lua 语言操作 Redis。从前面的命令可以看出 Redis 命令的计算能力并不算很强大,而使用 Lua 语言则在很大程度上弥补了 Redis 的这个不足。 只是在 Redis 中,执行 Lua 语言是原子性的, 也就说 Redis 执行 Lua 的时候是不会被中断的,具备原子性,这个特性有助于 Redis 对并发数据一致性的支持。 Redis 支持两种方法运行脚本, 一种是直接输入一些 Lua 语言的程序代码:另外一种是 将 Lua 语言编写成文件。在实际应用中, 一些简单的脚本可以采取第一种方式,对于有一 定逻辑的一般采用第二种方式。

1.执行输入 Lua 程序代码。 2.执行 Lua 文件。

相关知识

执行输入 Lua 程序代码

我们还是简单介绍下 Lua , Lua 是一种轻量小巧的脚本语言,其设计目的是为了嵌入应用程序中,从而为应用程序提供灵活的扩展和定制功能。

它的命令格式为:

命令

我们来分析下这些参数的含义:

  • eval代表执行 Lua 语言的命令。
  • script代表 Lua 语言脚本。
  • numkeys整数代表参数中有多少个 key ,需要注意的是 Redis 中 key 是从1开始的,如果没有 key 的参数,那么写0。
  • key[key…]是 key 作为参数传递给 Lua 语言,也可以不填它是 key 的参数,但是需要和 key-num 的个数对应起来。
  • arg[arg…]这些参数传递给 Lua 语言,它们是可填可不填的。

举例说明 Lua展示

这里可以看见执行两个Lua脚本。

,

这个脚本只是返回一个字符串,并不需要任何参数,所以 numkeys 填写了0,代表着没有任何 key 的参数,按照脚本只返回语句 hello java,所以执行后 Redis 也是这样返回的。这个例子很简单,只是返回一个字符串

,

设置一个键值对,可以在Lua语言中采用redis.call(command,key[param1,param2…])进行操作,其中:

  • command是命令,包括set、get、del等基础命令
  • key是被操作的键
  • param1,param2…代表给key的参数

脚本中的 KEYS[1] 代表读取传递给 Lua 脚本的第一个 key 参数,而 ARGV[1] 代表第一个非 key 参数。这里共有一个 key 参数,所以填写的 numkeys 为1,这样 Redis 就知道 key-value 是 key 参数,而 lua-value 是其他参数,它起到的是一种间隔的作用。最后我们可以看到使用 get 命令获取数据是成功的,所以 Lua 脚本运行成功了。

有时可能需要多次执行同样一段脚本,这个时候可以使用 Redis 缓存脚本的功能,在 Redis 中脚本会通过 SHA-1 签名算法加密脚本,然后返回一个标识字符串,可以通过这个字符串执行加密后的脚本。这样的一个好处在于,如果脚本很长,从客户端传输可能需要很长的时间,那么使用标识字符串,则只需要传递 32 位字符串即可,这样就能提高传输的效率,从而提高性能。

首先使用命令:

1
script load script 

后面的 script 代表 Lua 语言脚本。这个脚本的返回值是一个 SHA-1 签名过后的标识字符串,我们把它记为 shastring 。通过 shastring 可以使用命令执行签名后的脚本,命令的格式为:

,

我们再来演示一下这个过程:  使用签名运行 Lua 脚本

对于脚本签名后就可以使用 SHA-1 签名标识运行脚本了。我们可以用 Java 中使用 Lua 脚本:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
JedisPoolConfig config = new JedisPoolConfig();
config.setMaxTotal(100);
config.setMaxWaitMillis(1000);
config.setMaxIdle(10);
JedisPool pool = new JedisPool(config, "127.0.0.1", 6379, 2000, null);
Jedis jedis=pool.getResource();
//执行简单Lua的脚本
String hellojava= (String) jedis.eval("return 'hello java'");
System.out.println(hellojava);
//执行带参数的脚本
jedis.eval("redis.call('set',KEYS[1],ARGV[1])",1,"lua-key","lua-value");
System.out.println(jedis.get("lua-key"));
//缓存脚本,返回SHA-1签名标识
String sha1=jedis.scriptLoad("redis.call('set',KEYS[1],ARGV[1])");
//通过签名标识执行脚本
jedis.evalsha(sha1,1,new String[]{"sha-key","sha-val"});
//获取执行脚本后的数据
System.out.println(jedis.get("sha-key"));
//关闭连接
jedis.close();

上面代码演示的是简单字符串的存储,执行输出为:

1
2
3
hello java
lua-value
sha-val

但是现实中可能要存储对象,这个时候我们可以考虑使用 Spring 提供的 RedisScript 接口,它还是提供了一个实现类—— DefaultRedisScript ,让我们来了解他的使用方法。

先定义一个可序列化的对象 Role ,因为要序列化所以需要实现 Serializable 接口。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
import java.io.Serializable;
public class Role implements Serializable {
private static final long serialVersionUID=7247714666080613254L;
private Long id;
private String roleName;
private String note;
public static long getSerialVersionUID() {
return serialVersionUID;
}
public Long getId() {
return id;
}
public void setId(Long id) {
this.id = id;
}
public String getRoleName() {
return roleName;
}
public void setRoleName(String roleName) {
this.roleName = roleName;
}
public String getNote() {
return note;
}
public void setNote(String note) {
this.note = note;
}
}

接下来就可以通过Spring提供的 DefaultRedisScript 对象执行 Lua 脚本来操作对象。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
ApplicationContext applicationContext=new ClassPathXmlApplicationContext("applicationContext.xml");
RedisTemplate redisTemplate=applicationContext.getBean(RedisTemplate.class);
//定义默认脚本封装类
DefaultRedisScript<Role> redisScript = new DefaultRedisScript<>();
//设置脚本
redisScript.setScriptText("redis.call('set',KEYS[1],ARGV[1]) return redis.call('get',KEYS[1])");
//定义操作的key列表
List<String> keyList=new ArrayList<String>();
keyList.add("role1");
//需要序列化保护和读取的对象
Role role=new Role();
role.setId(1L);
role.setRoleName("role_name_1");
role.setNote("note_1");
//获得标识字符串
String sha1=redisScript.getSha1();
System.out.println(sha1);
//设置返回结果类型,如果没有返回,输出结果为空
redisScript.setResultType(Role.class);
//定义序列化器
JdkSerializationRedisSerializer serializer=new JdkSerializationRedisSerializer();
//执行脚本
//第一个是RedisScript接口对象,第二个是参数序列化器
//第三个是结果序列化器,第四个是Redis的key列表,最后是参数列表
Role obj=(Role) redisTemplate.execute(redisScript, serializer,serializer,keyList,role);
//打印结果
System.out.println(obj);

要注意的是,上面两个序列化器第一个是参数序列化器,第二个是结果序列化器。这里配置的是 Spring 提供的 JdkSerializationRedisSerializer ,如果在 Spring 配置文件中将 RedisTemplate 的 valueSerializer 属性设置为 JdkSerializationRedisSerializer ,那么使用默认的序列化器即可。

执行 Lua 文件

Lua 可以变成一个字符串传递给 Redis 执行,也可以直接执行Lua文件,尤其是当 Lua 脚本存在较多逻辑的时候,就很有必要单独编写独立的 Lua 文件。比如接下来这一段 Lua 脚本:

1
2
3
4
5
6
7
8
9
10
11
12
13
redis.call ('set', KEYS[1], ARGV[1])
redis.call ('set', KEYS[2], ARGV[2])
local n1=tonumber(redis.call('get',KEYS[1]))
local n2=tonumber(redis.call('get',KEYS[2]))
if n1>n2 then
return 1
end
if n1==n2 then
return 0
end
if n1<n2 then
return 2
end

这个 Lua 脚本是一个可以输入两个键和两个数字(记为n1和n2)的脚本,其意义就是先按键保存两个数字,然后去比较两个数字的大小。如果两个数字相等时,就返回0,如果 n1>n2 则返回1,如果 n2>n1 则返回2,且把它以文件名 test.lua 保存起来。这个时候可以对其进行测试,在 Windows 或者在 Linux 操作系统上执行下面的命令: ,

这里需要注意命令格式,执行的命令键和参数是使用逗号分隔的,而键之间是通过逗号分隔开的,从上图可以看出 key2 和参数之间是用逗号分隔的,而逗号前后的空格是不可以省略的,一定要注意,一旦左边的空格被省略了,否则Redis 就会认为“key,2”是一个键,一旦右边的空格被省略了,Redis 就会认为“,2”是一个键。

我们在 Java 中没有办法与客户端一样执行这样的文件脚本,一般使用 evalsha 命令来缓存脚本,并返回32位 SHA-1 标识,我们只需要传递这个标识和参数给 Redis 就可以了,使得通过网络传递给 Redis 的信息较少,从而提高了性能。如果使用 eval 命令去执行文件里的字符串,一旦文件很大,那么就需要通过网络反复传递文件,问题往往就出现在网络上,而不是 Redis 的执行效率上了。参考上面的例子去执行:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
public static void main(String[] args) {
ApplicationContext applicationContext=new ClassPathXmlApplicationContext("applicationContext.xml");
RedisTemplate redisTemplate=applicationContext.getBean(RedisTemplate.class);
//读入文件流
File file=new File("C:\\java\\com\\redis\\test.lua");
byte[] bytes= getFileToByte(file) ;
Jedis jedis=(Jedis)redisTemplate.getConnectionFactory().getConnection().getNativeConnection();
//发送文件二进制给Redis,这样Redis就会返回SHA-1标识
byte[] sha1=jedis.scriptLoad(bytes);
//使用返回的标识执行,其中第二个参数2,表示使用2个键
//而后面的字符串1都转化为二进制字节进行传输
Object obj=jedis.evalsha(sha1,2,"key1".getBytes(),"key2".getBytes(),"2".getBytes(),"4".getBytes());
System.out.println(obj);
}
//将文件转换为byte类型
private static byte[] getFileToByte(File file) {
byte[] by=new byte[(int) file.length()];
try {
InputStream is=new FileInputStream(file);
ByteArrayOutputStream bytestream=new ByteArrayOutputStream();
byte[] bb=new byte[2048];
int ch;
ch=is.read(bb);
while (ch!=-1){
bytestream.write(bb,0,ch);
ch=is.read(bb);
}
by=bytestream.toByteArray();
} catch (Exception e) {
e.printStackTrace();
}
return by;
}

如果我们将 SHA-1 这个二进制标识保存下来,那么可以通过这个标识反复执行脚本,只需要传递32位标识和参数即可,无需多次传递脚本。从对 Redis 的流水线的分析可知,系统性能不佳的问题往往并非是 Redis 服务器的处理能力,更多的是网络传递,因此传递更少的内容,有利于系统性能的提高。

这里采用比较原始的 Java Redis 连接操作 Redis ,还可以采用 Spring 提供 RedisScript 操作文件,这样就可以通过序列化器直接操作对象了。

任务代码

编程要求

  • 根据提示,在右侧编辑器 Begin - End 处补充代码,根据以下要求完成一次手机销售库存的操作:
    • 编写 ItemRedisTest.lua 文件,判断销售量是否比库存数量多,如果库存数量大于这次销售量,将新的库存数量更新到原来的 key 值上。
    • 编写 ItemRedisTest.java 文件,使用 BufferedReader 读取ItemRedisTest.lua 文件,使用 eval 命令执行文件里的字符串,设置手机销售量为10。
    • ItemRedisTest.lua 地址为:/data/workspace/myshixun/step5/ItemRedisTest.lua

ItemRedisTest.java

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
package com.redis;
import org.springframework.context.ApplicationContext;
import org.springframework.context.support.ClassPathXmlApplicationContext;
import org.springframework.data.redis.core.RedisTemplate;
import redis.clients.jedis.Jedis;
import java.io.BufferedReader;
import java.io.FileNotFoundException;
import java.io.FileReader;
import java.io.IOException;
public class ItemRedisTest {
public static void main(String[] args) throws IOException {
ApplicationContext applicationContext=new ClassPathXmlApplicationContext("applicationContext.xml");
RedisTemplate redisTemplate=applicationContext.getBean(RedisTemplate.class);
Jedis jedis=(Jedis)redisTemplate.getConnectionFactory().getConnection().getNativeConnection();
jedis.set("phone_item_stock", "100");
/************Begin************/
BufferedReader in= new BufferedReader(new FileReader("/data/workspace/myshixun/step5/ItemRedisTest.lua"));
String context =null;
String script="";
while (null != (context = in.readLine())){
script+=context+"\n";
}
Object obj = jedis.eval(script, 1,"phone_item_stock","10");
/************End************/
System.out.println("手机库存剩余:"+obj);
//关闭连接
jedis.close();
System.exit(0);
}
}

ItemRedisTest.lua

1
2
3
4
5
6
7
8
9
10
local count = redis.call('get', KEYS[1])
local a=tonumber(count)
local b=tonumber(ARGV[1])
---Begin
if a>=b then
redis.call('set',KEYS[1],count-b)
return redis.call('get', KEYS[1])
end

---End

4.Redis的常用配置

Redis 的常用配置,包括备份、回收策略、主从复制和哨兵模式

第1关:Redis的基础配置文件

1.Redis常见配置redis.conf

相关知识

Redis常见配置redis.conf

Redis的配置文件的使用在当下开发已十分普遍,Redis的配置文件放置在其安装目录下,如果是Windows系统,则默认的配置文件就是redis.window.conf;如果是Linux系统,则是redis.conf。在大部分的情况下我们都会使用到Linux环境,所以本章以Linux为主进行讲述。

编辑redis.conf文件,会看见文件中有很多配置,下面我们一起来看看这些配置代表着什么含义:

1、redis默认不是以守护进程的方式运行,可以通过该配置项修改,默认为no,可以使用yes启用守护进程:

2、当redis以守护进程方式运行时,redis默认会把pid写入/var/run/redis.pid文件,可以通过pidfile指定:

3、指定redis监听端口,默认端口号为6379,作者在自己的一篇博文中解析了为什么选用6379作为默认端口,因为6379在手机按键上MERZ对应的号码,而MERZ取自意大利女歌手Alessia Merz的名字:

4、绑定的主机地址:

5、当客户端闲置多长时间后关闭连接,如果指定为0,表示永不关闭:

6、设置检测客户端网络中断时间间隔,单位为秒,如果设置为0,则不检测,建议设置为60:

7、指定日志记录级别,redis总共支持四个级别:debug、verbose、notice、warning,

  • debug:会打印生成大量信息,适用于开发/测试阶段
  • verbose:包含很多不太有用的信息,但是不像debug级别那么混乱
  • notice:适度冗长,适用于生产环境
  • warning:仅记录非常重要、关键的警告消息

默认为verbose:

8、日志记录方式,默认为标准输出,如果配置redis为守护进程方式运行,而这里又配置为日志记录方式为标准输出,则日志将会发送给/dev/null:

9、设置数据库数量,默认值为16,默认当前数据库为0,可以使用select<dbid>命令在连接上指定数据库id:

10、指定在多长时间内,有多少次更新操作,就将数据同步到数据文件,可以多个条件配合: 这三个配置项的含义分别为:

  • 当900秒执行1个写命令时,启用快照备份。
  • 当300秒执行10个写命令时,启用快照备份。
  • 当60秒执行10000个写命令时,启用快照备份。

11、指定存储至本地数据库时是否压缩数据,默认为yes,redis采用LZF压缩,如果为了节省CPU时间,可以关闭该选项,但会导致数据库文件变得巨大:

12、指定本地数据库文件名,默认值为dump.rdb:

13、指定本地数据库存放目录:

14、设置当本机为slave服务时,设置master服务的IP地址及端口,在redis启动时,它会自动从master进行数据同步:

15、当master服务设置了密码保护时,slave服务连接master的密码:

16、设置redis连接密码,如果配置了连接密码,客户端在连接redis时需要通过auth <password>命令提供密码,默认关闭:

17、设置同一时间最大客户端连接数,默认无限制,redis可以同时打开的客户端连接数为redis进程可以打开的最大文件描述符数,如果设置maxclients 0,表示不作限制。当客户端连接数到达限制时,redis会关闭新的连接并向客户端返回 max number of clients reached错误消息:

18、指定redis最大内存限制,redis在启动时会把数据加载到内存中,达到最大内存后,redis会先尝试清除已到期或即将到期的key,当次方法处理后,仍然到达最大内存设置,将无法再进行写入操作,但仍然可以进行读取操作。Redis新的vm机制, 会把key存放内存,value会存放在swap区:

19、设置缓存过期策略,有6种选择:(LRU算法最近最少使用)

  • volatile-lru:使用LRU算法移除key,只对设置了过期时间的key;
  • allkeys-lru:使用LRU算法移除key,作用对象所有key;
  • volatile-random:在过期集合key中随机移除key,只对设置了过期时间的key;
  • allkeys-random:随机移除key,作用对象为所有key;
  • volarile-ttl:移除哪些ttl值最小即最近要过期的key;
  • noeviction:永不过期,针对写操作,会返回错误信息。

20、指定是否在每次更新操作后进行日志记录,redis在默认情况下是异步的把数据写入磁盘,如果不开启,可能会在断电时导致一段时间内数据丢失。因为redis本身同步数据文件是按上面save条件来同步的,所以有的数据会在一段时间内置存在于内存中。默认为no:

21、指定更新日志文件名,默认为appendonly.aof

22、指定更新日志条件,共有3个可选值:

  • no:表示等操作系统进行数据缓存同步到磁盘(快);
  • always:表示每次更新操作后手动调用fsync()将数据写到磁盘(慢,安全);
  • everysec:表示每秒同步一次(折中,默认值)。

任务

编程要求

根据相关知识,按照要求完成右侧选择题任务,包含单选题和多选题。
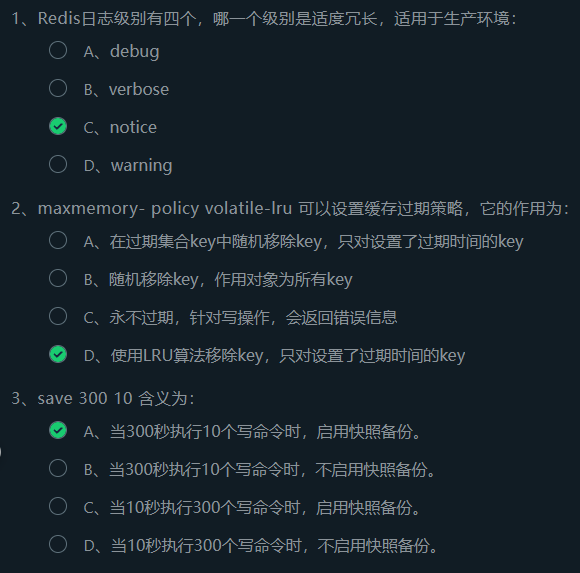
选择题

第2关:Redis 的高级配置

1.Redis备份(持久化)。

2.Redis内存回收策略。

3.复制。

4.哨兵模式。

相关知识

Redis备份(持久化)

在 Redis 中存在两种方式的备份:一种是快照,它是备份当前瞬间 Redis 在内存中的数据记录;另一种是只追加文件,其作用就是当 Redis 执行写命令后,在一定的条件下将执行过的写命令依次保存在 Redis 的文件中,将来就可以依次执行那些保存的命令恢复 Redis 的数据了。对于快照备份而言,如果当前 Redis 的数据量大,备份可能造成 Redis 卡顿,但是恢复重启时比较快速的;对于 AOF 备份而言,它只是追加写入命令,所以备份一般不会造成 Redis 卡顿,但是恢复重启要执行更多的命令,备份文件可能也很大,使用者使用的时候要注意。在 Redis 中允许使用其中的一种、同时使用两种,或者两者都不用,所以具体使用何种方式进行备份和持久化是用户可以通过配置决定的。 我们来介绍一下这些默认配置:

1
2
3
save 900 1
save 300 10
save 60 10000

这3个配置项的含义分别为:

  • 当 900 秒执行 1 个写命令时,启用快照备份。
  • 当 300 秒执行 10 个写命令时,启用快照备份。
  • 当 60 秒内执行 10000 个写命令时,启用快照备份。

Redis 执行 save 命令的时候,将禁止写入命令。

1
stop-writes-on-bgsave-error yes

这里先谈谈 bgsave 命令,它是一个异步保存命令,也就是系统将启动另外一条进程,把 Redis 的数据保存到对应的数据文件中。它和 save 命令最大的不同是它不会阻塞客户端的写入,也就是在执行 bgsave 的时候,允许客户端继续读/写 Redis 。在默认情况下,如果 Redis 执行 bgsave 失败后,Redis 将停止接受写操作,这样以一种强硬的方式让用户知道数据不能正确的持久化到磁盘,否则就会没人注意到灾难的发生,如果后台保存进程重新启动工作了, Redis 也将自动允许写操作。然而如果安装了靠谱的监控,可能不希望 Redis 这样做,那么你可以将其修改为 no。

1
rdbchecksum yes

这个命令意思是是否对 rbd 文件进行检验,如果是将对 rdb 文件检验。从 dfilename 的配置可以知道,rdb 文件实际是 Redis 持久化的数据文件。

1
dbfilename dump.rdb

它是数据文件。当采用快照模式备份(持久化)时,Redis 将使用它保存数据,将来可以使用它恢复数据。

1
appendonly no

如果 appendonly 配置 no,则不启用 AOF 方式进行备份。如果 appendonly 配置为 yes,则以 AOF 方式备份 Redis 数据,那么此时 Redis 会按照配置,在特定的时候执行追加命令,用以备份数据。

1
appendfilename "appendonly.aof"

这里追加的写入文件为 appendonly.aof,采用 AOF 追加文件备份的时候命令都会写到这里。

1
2
3
# appendfsync always
appendfsync everysec
# appendfsync no

AOF 文件和 Redis 命令是同步频率的,假设配置为 always ,其含义为当 Redis 执行命令的时候,则同时同步到 AOF 文件,这样会使得 Redis 同步刷新 AOF 文件,造成缓慢。而采用 evarysec 则代表每秒同步一次命 令到 AOF 文件。采用 no 的时候,则由客户端调用命令执行备份,Redis 本身不备份文件。对于采用 always 配置的时候,每次命令都会持久化,它的好处在于安全,坏处在于每次都持久化性能较差。采用 evarysec 则每秒同步,安全性不如 always ,备份可能会丢失 1 秒以内的命令,但是隐患也不大,安全度尚可,性能可以得到保障。采用 no ,则性能有所保障,但是由于失去备份,所以安全性比较差。

建议采用默认配置 everysec ,这样在保证性能的同时,也在一定程度上保证了安全性。

1
no-appendfsync-on-rewrite no

它指定是否在后台 AOF 文件 rewrite (重写)期间调用 fsync ,默认为 no ,表示要调用 fsync(无论后台是否有子进程在刷盘)。Redis 在后台写 RDB 文件或重写 AOF 文件期间会存在大量磁盘I/O,此时,在某些 Linux 系统中,调用 fsync 可能会阻塞。

1
auto-aof-rewrite-percentage 100

他指定 Redis 重写 AOF 文件的条件,默认为100,标识与上次 rewire 的 AOF 文件大小相比,当前 AOF 文件增长量超过上次 AOF 文件大小的100%时,就会触发 backgroundrewrite 。若配置为 0,则会禁用自动 rewrite 。

1
auto-aof-rewrite-min-size 64mb

它指定触发 rewrite 的 AOF 文件大小。若 AOF 文件小于该值,即使当前文件的增量比例到达 auto-aof-rewrite-percentage 的配置值,也不会触发自动 rewrite。即这两个配置项同时满足时,才会触发 rewrite。

1
aof-load-truncated yes

Redis 在恢复时会忽略最后一条可能存在问题的指令,默认为 yes。即在 AOF 写入时,可能存在指令写错的问题(突然断电),这种情况下 yes会 log 并继续,而 no 会直接恢复失败。

Redis内存回收策略

Redis 也会因为内存不足而产生错误,也有时候因为长时间回收导致系统长期的停顿,因此掌握执行回收策略十分有必要。在 Redis 的配置文件中,当Redis的内存到达规定的最大值时,允许配置6种策略中的一种进行淘汰键值,并且将一些键值对进行回收,让我们来看看它们具有哪些特点。

Redis 对其中一个配置项——maxmemory-policy,提供了这样的一段描述:

我们来介绍下这 6 种策略的含义:

  • valatile-lru:采用最少的淘汰策略删除超时的键值对,作用对象为超时对象。
  • allkeys-lru:采用最少的淘汰策略删除键值对,作用对象为所有对象。
  • volatile-random:采用随机淘汰策略随机删除超时的键值对,作用对象为超时对象。
  • allkeys-random:采用随机淘汰策略随机删除键值对,作用对象为所有对象。
  • volatile-ttl:删除存活时间最小即将超时的键值对。
  • noeviction:永不过期,当内存已满时,如果读操作正常工作,而写操作,会返回错误信息。

Redis 默认情况下会采用 noeviction 策略。然而 noeviction 策略当内存已满时,是只能读取不能写入,所以不能满足我们所有的要求,因为对互联网系统而言,常常会涉及数以百万甚至更多的用户,所以往往需要设置回收策略。

这里需要指出的是:LRU 算法或者 TTL 算法都不是很精确的算法,而是一个近似的算法。 Redis 不会通过对全部的键值对进行比较来确定最精确的时间值,从而确定删除哪个键值对,因为这将消耗太多的时间,导致回收垃圾执行的时间太长,造成服务停顿。而在 Redis 的默认配置文件中,存在着参数 maxmemory-samples ,它的默认值为 3 ,假设采取了 volatile-ttl 算法,让我们去了解这样的一个回收过程,假设当前有 4 个即将超时的键值对:

键值对 剩余超时秒数
a 5
b 4
c 6
d 3

因为 maxmemory-samples 的值为 3 ,所以他只会取到前三个样本,然后进行比较。因为 b 剩余秒数最少,所以 b 是最先被删除的。但是剩余超时秒数最短的 d 还在内存中,因为它不属于探测样本中的。这就是 Redis 中采用的近似算法。当设置 maxmemory-samples 越大,则 Redis 探测样本的数量越多,删除的就越精确,但是它的缺点会让使用的时间越长。

回收超时策略不足的是删除必须指明超时的键值对,这样会让代码量增长,加大开发者的工作任务。但是针对所有的键值对进行回收,有可能把正在使用的键值对删除掉,增加了存储的不稳定性。对于垃圾回收的策略,还需要注意的是回收的时间,因为在 Redis 对垃圾的回收期间,会造成系统缓慢。因此,控制其回收时间有一定好处,只是这个时间不能过短或过长。过短则会造成回收次数过于频繁,过长则导致系统单次垃圾回收停顿时间过长,都不利于系统的稳定性,这些都需要设计者在实际的工作中进行思考。

复制

尽管Redis的性能不错,但是面对每秒成千上万的请求,大量的读操作就会到达Redis服务器,触发许许多多的操作,靠一台Redis服务器是完全不够用的。一些服务网站对安全性有较高的要求,当主服务器不能正常工作时,也需要从服务器代替原来的主服务器,作为灾难备份,以保证系统可以继续正常的工作。因此更多的时候我们要将读/写分离,因为读操作远远比写操作频繁的多,如果把数据都存放在多台服务器上那么就可以从多台服务器中读取数据,从而消除了单台服务器的压力,我们也可以基于主从复制,构建哨兵模式与集群,实现Redis的高可用方案。

主从同步基础概念

互联网系统一般是以主从架构为基础的,所谓主从架构的设计的思路大概是:

  • 在多台数据服务器中,只有一台主服务器,而主服务器只负责写入数据,不负责外部程序读取数据。
  • 存在多台从服务器,从服务器不写入数据,只负责同步主服务器的数据,并让外部程序读取数据。
  • 主服务器写入数据后,即刻将写入数据的命令发送给从服务器,从而使得主从数据同步。
  • 应用程序可以随机读取某一台从服务器的数据,这样就可以分摊读取数据的压力。
  • 当从服务器不能工作时,整个系统将不受影响;当主服务器不能工作时,可以方便地从从服务器选举一台来当主服务器。

大家可以看下主从同步机制图,更加理解 Redis 的复制机制: Redis 的复制机制

可以从机制图看出,我们读取数据是在从服务器上读取的,当从服务器是多台的时候,那么单台服务器的压力就大大降低了,这十分有利于系统性能的提高,当主服务器不能工作的情况时,也可以切换为其中的一台从服务器继续让系统稳定运行,所以也有利于系统运行的安全性。当然由于Redis自身具备的特点,所以其也有实现主从同步的特殊方式。

Redis主从同步配置

对Redis进行主从同步的配置分为主机与从机,主机是一台,而从机可以是多台。 首先我们要明确主机,关建两个配置是dir和dbfilename选项,dir的默认值为./,dbfilename默认采用Redis当前目录的dump.rbd文件进行同步。其次,明确了从机之后,进行进一步配置所要关注的只有slaveof这个配置选项:

其中masterip代表主机地址,masterport代表主机端口。当从机Redis服务重启时,就会同步对应主机的数据了。当不想让从机继续复制主机的数据时,可以在从机的Redis命令客户端发送slaveof no one 命令,这样从机就不会再接收主服务器的数据更新了。又或者原来主服务器已经无法工作了,而你可能需要复制新的主机,这个时候执行slaveof masterip masterport 就能让从机复制另外一台主机的数据了。 在实际的Linux环境中,配置文件redis.conf中还有一个bind的配置,默认为127.0.0.1,也就是只允许本机访问,把它修改为bind 0.0.0.0,其他的服务器就能够访问了。

Redis主从同步的过程

Redis主从同步共分为5步:

  1. 主服务器开启后,从服务器连接主服务器,发送SYNC命令
  2. 主服务器接收到SYNC命名后,开始执行bgsave命令生成RDB文件并使用缓冲区记录此后执行的所有写命令;
  3. 主服务器bgsave执行完后,向所有从服务器发送快照文件,并在发送期间继续记录被执行的写命令,从服务器收到快照文件后丢弃所有旧数据,载入收到的快照;
  4. 主服务器快照发送完毕后开始向从服务器发送缓冲区中的写命令;
  5. 从服务器完成对快照的载入,开始接收命令请求,并执行来自主服务器缓冲区的写命令。

Redis 主从同步的过程图如下: Redis 主从同步的过程图

只要在主服务器同步到从服务器的过程中,需要备份文件,所以在配置的时候一般需要预留一些内存空间给主服务器,用来腾出空间执行备份命令。一般来说主服务器使用50%~60%的内存空间,为主从复制留下可用的内存空间。

哨兵模式

主从切换技术的方法是:当主机服务器宕机后,需要手动把一台从服务器切换为主服务器,这就需要人工干预,既费时又费力,还会造成一段时间内服务不可用,这不是一个推荐的方式,所以我们考虑哨兵模式,它是当前企业应用的主流方式。

哨兵模式概述

Redis可以存在多台服务器,并且实现了主从复制的功能。哨兵模式是一种特殊的模式,首先 Redis 提供了哨兵的命令,哨兵是一个独立的进程。其原理是哨兵通过发送命令,等待Redis服务器相应,从而监控运行的多个Redis实例。如下图:

这里哨兵有两个作用:

  1. 通过发送命令,让Redis服务器返回检测其运行状态,包括主服务器和从服务器。
  2. 当哨兵监测到master宕机,会自动将slave切换成master,然后通过发布订阅模式通知到其他的从服务器,修改配置文件,让它们自动切换主机。

只是现实中一个哨兵进程对Redis服务器进行监控,也可能出现问题,为了处理这个问题,还可以使用多个哨兵的监控,而各个哨兵之间还会相互监控,这样就变为了多个哨兵模式。多个哨兵不仅监控各个Redis服务器,而且哨兵之间互相监控,看看哨兵们是否还存在着。 论述下故障切换的过程。假设主服务器宕机,哨兵1先检测到这个结果,当时系统并不会马上进行切换操作,而仅仅是哨兵1主观地认为主机不可用,这个现象被称为主观下线。当后面的哨兵监测到了主服务器不可用,并且有了一定的数量的哨兵认为主服务器不可用,那么哨兵之间就会形成一次投票,投票结果由一个哨兵发起,进行故障切换操作,在操作的过程中切换成功后,就会通过发布订阅方式,让各个哨兵把自己监控的服务器实现切换主机,这个过程被称为客观下线。

搭建哨兵模式

配置3个哨兵和1主2从的Redis服务器来演示这个过程。

服务类型 是否主服务器 IP地址 端口
Redis 是 192.168.44.128 6379
Redis 否 192.168.44.129 6379
Redis 否 192.168.44.130 6379
Sentinel - 192.168.44.128 26379
Sentinel - 192.168.44.129 26379
Sentinel - 192.168.44.130 26379

接下来修改redis.conf文件进行配置:

1
2
3
4
5
6
7
8
#使得 Redis 服务器可以跨网络访问
bind 0.0.0.0
#设置密码
requirepass "redis123"
#指定主服务器,注意:有关slaveof的配置只是配置从服务器,而主服务器不需要配置
slaveof 192.168.44.128 6379
#主服务器密码,注意:有关 slaveof 的配置只是配置从服务器,而主服务器不需要配置
masterauth redis123

修改sentinel.conf文件进行配置:

1
2
3
4
5
6
7
8
9
10
11
12
#禁止保护模式
protected-mode no
#配置监听的主服务器,这里sentinel monitor 代表监控,
#mymaster代表服务器名称,可以自定义
#192.168.44.128代表监控的主服务器
#6379代表端口
#2 代表只有两个或者两个以上的哨兵认为主服务器不可用的时候,才会做故障切换操作
sentinel monitor mymaster 192.168.44.128 6379 2
#sentinel auth-pass 定义服务的密码
#mymaster服务名称
#redis123 Redis服务器密码
sentinel auth-pass mymaster redis123

上述关闭了保护模式,以便于测试。

我们启动Redis服务器和哨兵:

1
2
3
4
#启动哨兵进程
./redis-sentinel ../sentinel.conf
#启动Redis服务器进程
./redis-server ../redis.conf

要注意启动的顺序,首先是主机Redis服务进程,然后启动从服务器,最后启动哨兵的服务进程。

在Java中使用哨兵模式

在Java中使用哨兵模式,只需要加入关于哨兵的信息即可:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
//连接池配置
JedisPoolConfig jedisPoolConfig =new JedisPoolConfig();
jedisPoolConfig.setMaxTotal(10) ;
jedisPoolConfig.setMaxIdle(5);
jedisPoolConfig.setMinIdle(5);
//哨兵信息
Set<String> sentinels =new HashSet<String>(Arrays.asList(
"192.168.44.128:26379",
"192.168.44.129:26379",
"192.168.44.130:26379"
));
//创建连接池
//mymaster是我们配置给哨兵的服务名称
//sentinels是哨兵信息
//jedisPoolConfig是连接池配置
//redis123是连接Redis服务器的密码
JedisSentinelPool pool=new JedisSentinelPool("mymaster",sentinels,jedisPoolConfig,"redis123");
//获取客户端
Jedis jedis = pool.getResource();
//执行两个命令
jedis.set("mykey","myvalue");
String myvalue=jedis.get("mykey");
//打印信息
System.out.println(myvalue);

通过上述的代码就能够连接Redis服务器了,这个时候将启动主机提供服务。为了验证哨兵的作用,我们可以把主机上的Redis服务器关闭,Redis哨兵会进行投票切换主机,我们就可以得到下面的日志: 日志 从从日志可以看到,我们现在使用的是从服务器192.168.44.130,这是因为主服务器192.168.44.128不可用后,哨兵们经过投票最终切换为从服务器192.168.44.130,通过这样的自动切换就保证服务能够持续稳定运行了。

同样的,通过配置也可以实现在SpringBoot中测试哨兵:

配置application.yml文件:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
spring:
redis:
cluster:
# 集群模式下,逗号分隔的键值对(主机:端口)形式的服务器列表
nodes: 192.168.44.128:6379,192.168.44.129:6379,192.168.44.130:6379
#集群模式下,集群最大转发的数量
max-redirects: 3
sentinel:
#哨兵模式下,逗号分隔的键值对(主机:端口)形式的服务器列表
nodes: 192.168.44.128:26379,192.168.44.129:26379,192.168.44.130:26379
#哨兵模式下,Redis主服务器地址
master: mymaster
# 使用数据库的索引编号,一个示例有16个数据库 0 到 15
database: 0
lettuce:
pool:
# 连接池最大连接数(使用负值表示没有限制) 默认为8
max-active: 8
# 连接池最大阻塞等待时间(使用负值表示没有限制) 默认为-1
max-wait: -1
# 连接池中的最大空闲连接 默认为8
max-idle: 8
# 连接池中的最小空闲连接 默认为 0
min-idle: 0
# Redis服务器的密码
password: redis123
# 连接超时,毫秒为单位
timeout: 6000

要注意这里使用的是 lettuce 客户端而不是 Jedis 客户端,因为在 springboot 1.5.x版本的默认的Redis客户端是 Jedis实现的,springboot 2.x版本中默认客户端是用 lettuce实现的。这两个客户端的区别:

  1. Jedis是直接连接redis server ,如果在多线程环境下是非线程安全的,这个时候只有使用连接池,为每个 Jedis 实例增加物理连接。
  2. Lettuce的连接是基于Netty的,连接实例可以在多个线程间并发访问,应为StatefulRedisConnection是线程安全的,所以一个连接实例就可以满足多线程环境下的并发访问,当然这个也是可伸缩的设计,一个连接实例不够的情况也可以按需增加连接实例。

单元测试:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
import org.junit.Test;
import org.junit.runner.RunWith;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.boot.test.context.SpringBootTest;
import org.springframework.data.redis.core.RedisTemplate;
import org.springframework.data.redis.core.ValueOperations;
import org.springframework.test.context.junit4.SpringRunner;
@RunWith(SpringRunner.class)
@SpringBootTest
public class RedisConfigurationTest {
@Autowired
private RedisTemplate<String,String> redisTemplate;
@Test
public void test(){
ValueOperations<String, String> opsForValue = redisTemplate.opsForValue();
opsForValue.set("redisTest","HelloWorld");
System.out.println(opsForValue.get("redisTest"));
}
}

输出结果为:HelloWorld

任务代码

编程要求

根据提示,在右侧编辑器补充代码,根据以下要求测试连接单节点Redis和哨兵。 在application.yml文件中配置

  • spring.redis.cluster.node 为127.0.0.1:6379
  • spring.redis.sentinel.nodes为 127.0.0.1:26379
  • spring.redis.sentinel.master为mymaster

在RedisController编写代码,实现设置key值为HelloWorld并返回key值。

RedisController.java

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
package com.example.springredis.controller;

import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.data.redis.core.RedisTemplate;
import org.springframework.data.redis.core.ValueOperations;
import org.springframework.stereotype.Controller;
import org.springframework.web.bind.annotation.RequestMapping;
import org.springframework.web.bind.annotation.ResponseBody;

@Controller
public class RedisController {
@Autowired
RedisTemplate<String,String> redisTemplate;

@RequestMapping("/index")
@ResponseBody
public String get(){
ValueOperations<String, String> opsForValue = redisTemplate.opsForValue();
//*********** Begin ***********
opsForValue.set("redisTest","HelloWorld");
return opsForValue.get("redisTest");
//*********** End ***********
}
}

application.yml

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
spring:
redis:
#************ Begin ************
cluster:
# 集群模式下,逗号分隔的键值对(主机:端口)形式的服务器列表
nodes: 127.0.0.1:6379,127.0.0.1:6379,127.0.0.1:6379
sentinel:
#哨兵模式下,逗号分隔的键值对(主机:端口)形式的服务器列表
nodes: 127.0.0.1:26379,127.0.0.1:26379,127.0.0.1:26379
#哨兵模式下,Redis主服务器地址
master: mymaster
#************ End ************
# 使用数据库的索引编号,一个示例有16个数据库 0 到 15
database: 0
lettuce:
pool:
# 连接池最大连接数(使用负值表示没有限制) 默认为8
max-active: 8
# 连接池最大阻塞等待时间(使用负值表示没有限制) 默认为-1
max-wait: -1
# 连接池中的最大空闲连接 默认为8
max-idle: 8
# 连接池中的最小空闲连接 默认为 0
min-idle: 0
# 连接超时,毫秒为单位
timeout: 6000

END

任务地址:
头歌编程:Redis概述
头歌编程:Redis常用数据结构
头歌编程:Redis一些常用的技术
头歌编程:Redis的常用配置


SSM框架-Redis
http://example.com/2021/10/06/SSM关于Redis/
Author
lzdong
Posted on
October 6, 2021
Licensed under